Whisper turbo + pyannote로 화자분리 전사 서비스 만들기: 파이프라인부터 환각 잡는 법까지
회의나 면담 녹음을 사람이 직접 듣고 받아 적으면 1시간 분량에 보통 3~4시간이 깨진다. 이 시간을 줄이려고 허깅페이스(Hugging Face)에 공개된 Whisper large-v3-turbo와 화자분리 모델 pyannote를 묶어서, 녹음 파일을 넣으면 "누가, 언제, 무슨 말을 했는지" 대본으로 뽑아주는 서비스를 직접 만들어 운영하고 있다.
막상 붙여보니 기본 받아쓰기 품질은 생각보다 괜찮았다. 근데 실무에 쓰다 보면 꼭 마주치는 골칫거리가 하나 있는데, 녹음에 아예 없는 문장이 대본 중간에 끼어드는 환각(Hallucination) 현상이다. 실제로 묶어 둔 전체 파이프라인 구조와 이 환각을 걸러내는 필터 구성을 정리해 둔다.
본문 속 대화 예시와 처리 시간은 설명을 위해 만든 예시 값이다. 모델 사양(파라미터 수, 층 수 등)은 공식 문서를 기준으로 적었다.
전체 파이프라인 6단계
녹음 파일 하나가 대본으로 나오기까지 크게 6단계를 거친다. 핵심은 무슨 말을 했는지(Whisper)와 누가 말했는지(pyannote)를 각자 뽑아낸 뒤, 타임스탬프를 기준으로 합치는 구조다.
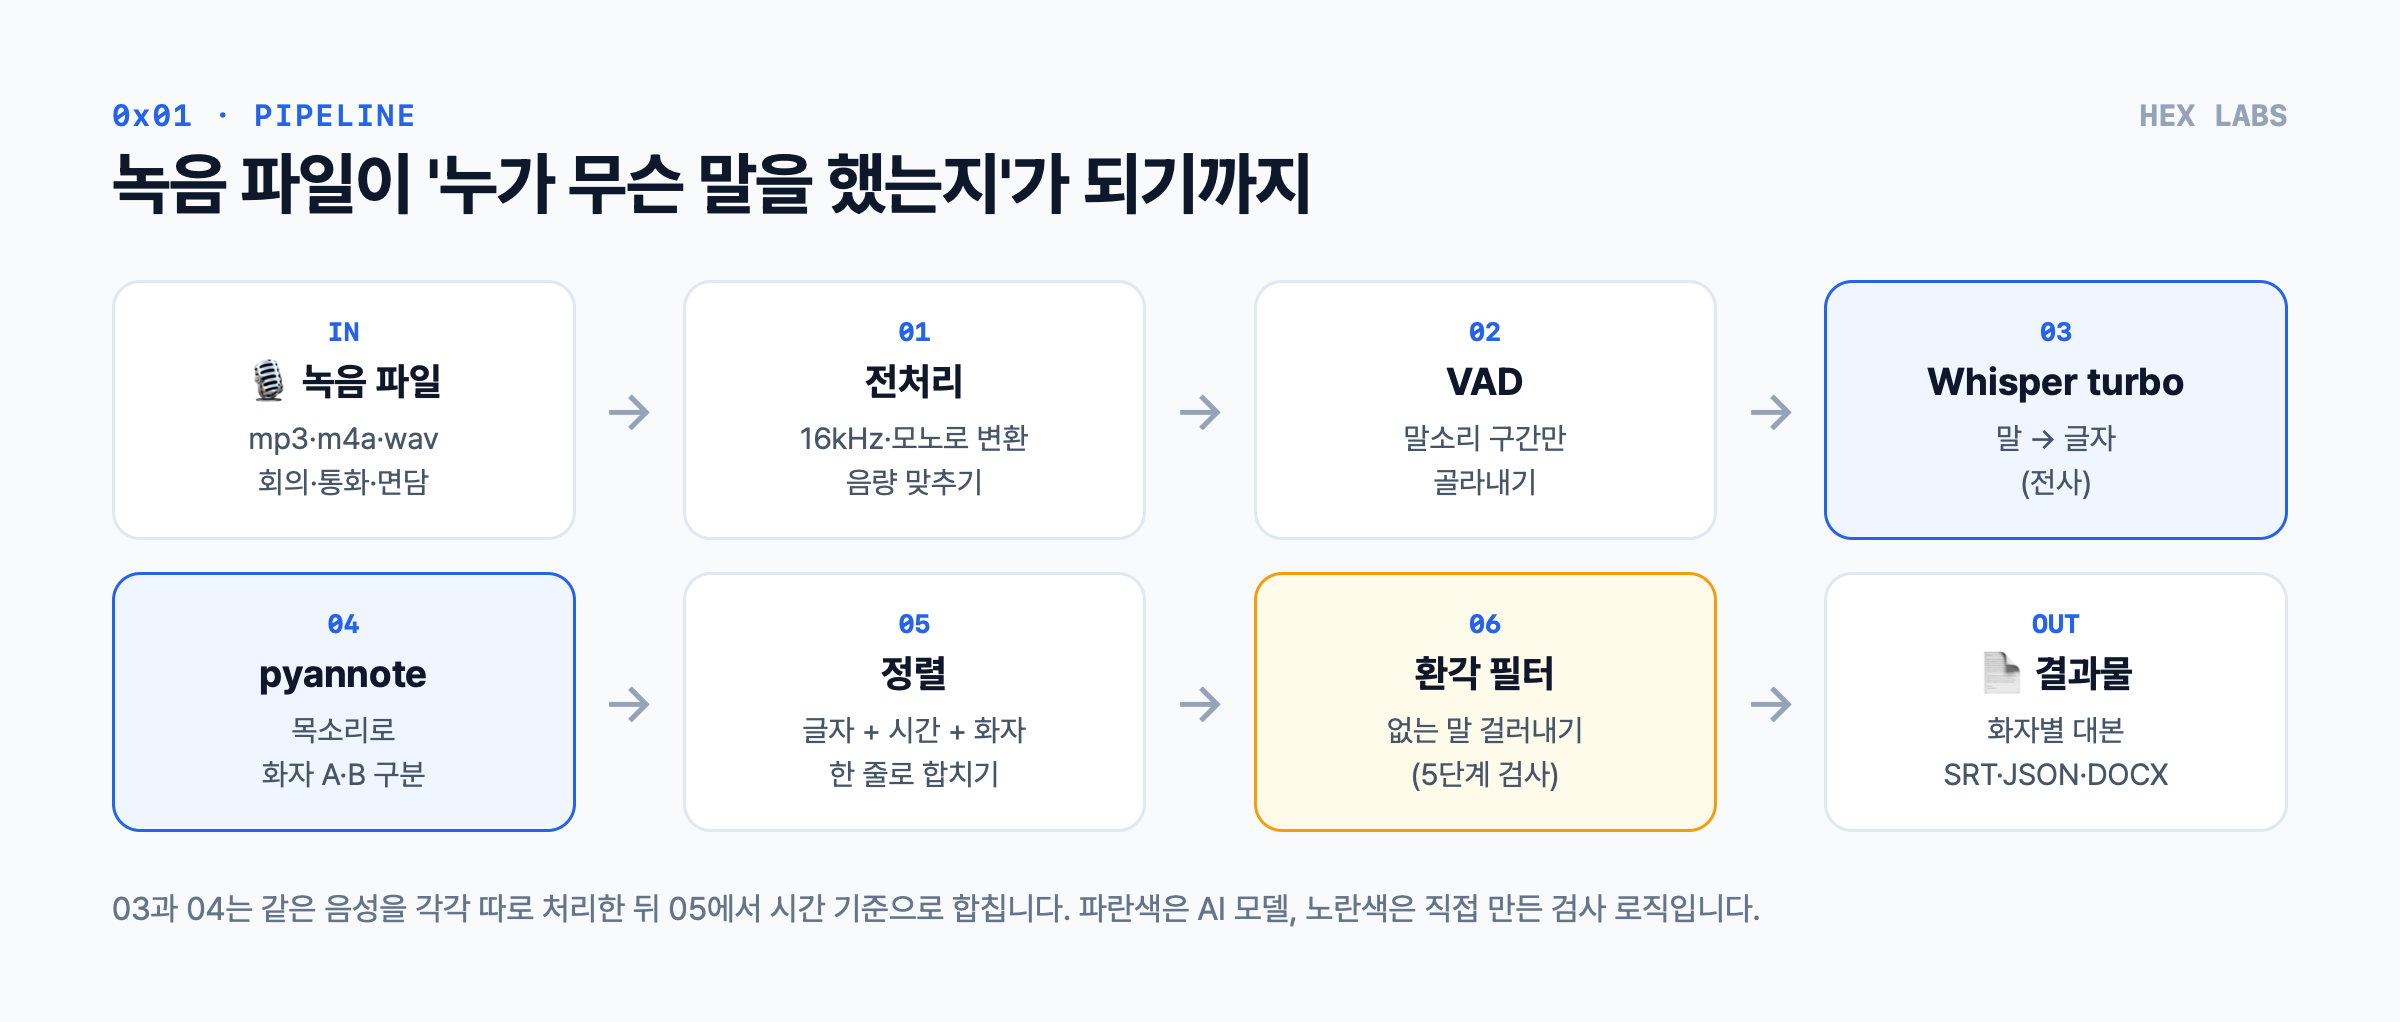
- 전처리 — 들어오는 오디오 형식이 제각각이라 16kHz·모노(단일 채널)로 먼저 통일한다.
- VAD(음성 구간 검출) — 사람 목소리가 들어 있는 구간만 발라낸다. 침묵 구간을 미리 잘라내는 게 환각을 줄이는 데 제일 중요하다.
- 전사(STT) — Whisper turbo로 말소리를 텍스트로 바꾸면서 단어별 시작·끝 시각을 함께 뽑는다.
- 화자분리(Diarization) — pyannote가 목소리 특징을 비교해 화자 A, 화자 B 식으로 구분하고 각자 말한 시간 구간을 잡는다.
- 시간 정렬 — 3번의 단어 타임스탬프와 4번의 화자 구간을 겹쳐서 "00:00:09 화자 B: 네, 그날은…" 형태로 매칭한다.
- 환각 필터 — 실제로 발화하지 않은 문장을 여러 조건으로 교차 검사해 걸러낸다.
Whisper large-v3-turbo를 쓴 이유
OpenAI가 공개한 Whisper는 소리를 듣고 특징을 뽑는 인코더와 그걸 글자로 풀어 쓰는 디코더로 나뉜다. turbo 버전은 인코더는 그대로 두고 디코더만 기존 32층에서 4층으로 확 줄인 모델이다. 전체 파라미터 수가 약 15억 5천만 개에서 8억 900만 개로 줄면서, 공식 기준 속도는 약 8배 빨라지고 정확도 손실은 미미한 수준으로 맞췄다.
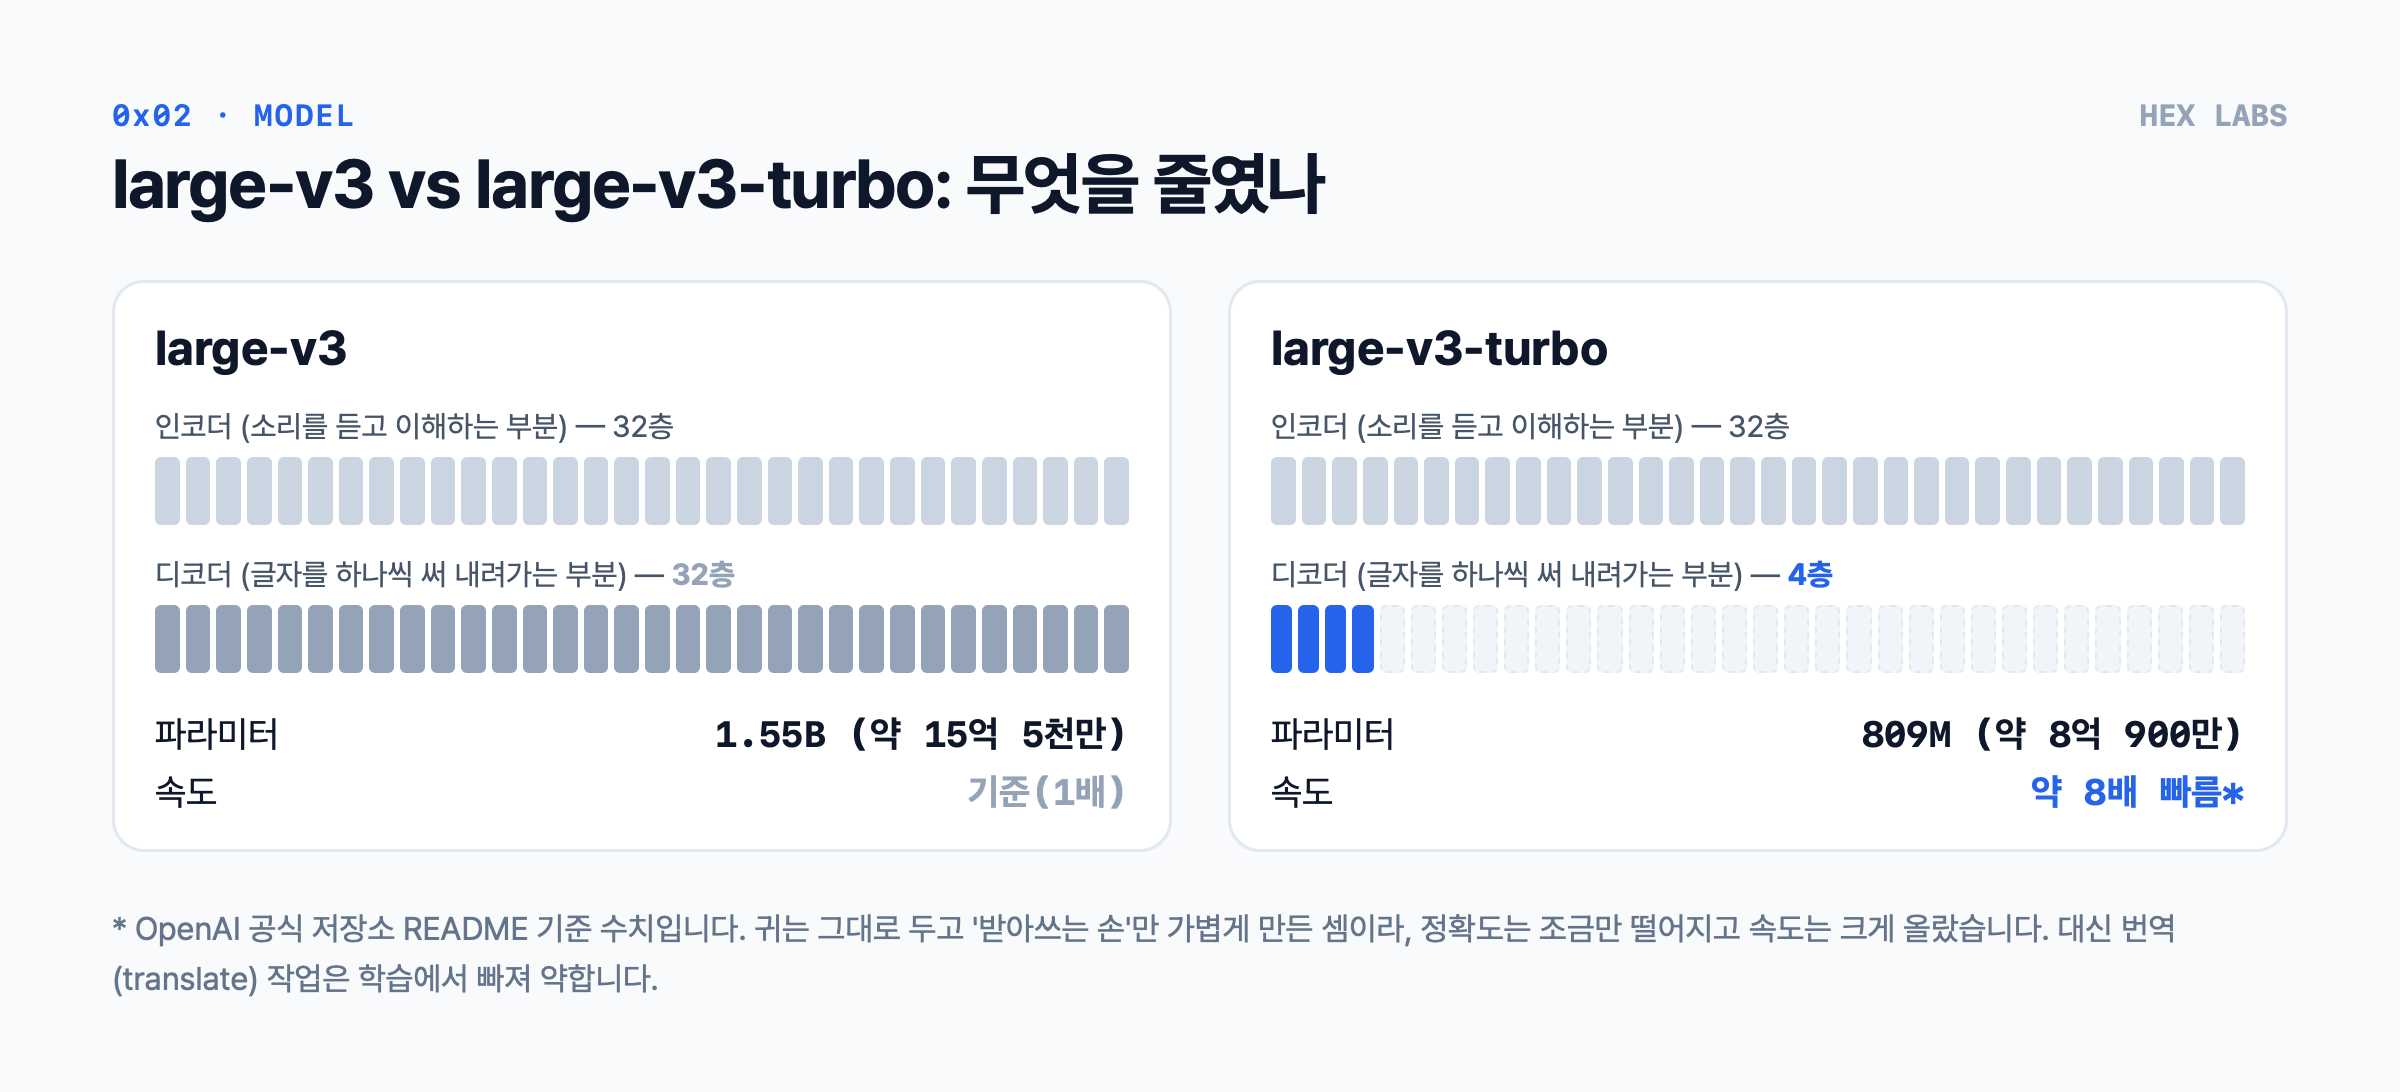
turbo 모델은 다국어 번역(translate) 학습이 빠져 있어서 한국어 음성을 바로 영어 자막으로 바꾸는 식의 작업에는 약하다. 한국어 녹음을 한국어 텍스트로 그대로 받아 적는 용도라면 문제없다.
실제로 돌려보면 속도 체감이 꽤 크다. 같은 GPU 환경에서 38분짜리 면담 녹음이 2분 안쪽으로 끝난다(예시 환경 기준). 사람이 처음부터 다 받아 적던 시간과 비교하면, 초안을 빠르게 뽑고 틀린 부분만 검수하는 쪽이 훨씬 낫다.
pyannote로 화자 구간 나누기
Whisper 단독으로는 글자만 뽑아줄 뿐 누가 한 말인지는 구분하지 못한다. 그래서 화자분리 모델인 pyannote를 같이 물렸다. 목소리의 높낮이나 음색 특징을 숫자 벡터(임베딩)로 바꾼 뒤 비슷한 목소리 조각끼리 묶어서 시간대별 화자를 표시해 준다.
2025년에 나온 pyannote.audio 4.0과 공개 모델 community-1로 올리면서 체감상 두 가지가 편해졌다.
- 화자 군집화 방식이 VBx 클러스터링으로 바뀌면서 중간에 화자가 엉뚱하게 뒤바뀌는 빈도가 줄었다.
- 한 시점에 한 명의 화자만 남기는 exclusive 모드가 추가됐다. 두 사람이 동시에 겹쳐 말할 때 Whisper가 뽑은 단어를 누구 쪽에 붙일지 애매하던 문제를 처리하기가 한결 수월해졌다.
pyannote 가중치는 허깅페이스에서 이용 약관에 동의하고 액세스 토큰을 발급받아야 내려받을 수 있다. 토큰은 코드에 하드코딩하지 않고 환경 변수로 빼서 관리하는 게 기본이다.
핵심 파이프라인 코드
실제 운영 중인 서비스에는 작업 큐나 파일 보관 정책, 예외 처리가 더 붙어 있지만, 전사와 화자분리를 묶는 뼈대만 추리면 아래와 같다.
import os, torch
from transformers import pipeline
from pyannote.audio import Pipeline

# 1) 전사 모델: Whisper large-v3-turbo
asr = pipeline(
    "automatic-speech-recognition",
    model="openai/whisper-large-v3-turbo",
    torch_dtype=torch.float16,
    device="cuda:0",
)

# 2) 화자분리 모델: pyannote community-1 (pyannote.audio 4.x)
diar = Pipeline.from_pretrained(
    "pyannote/speaker-diarization-community-1",
    token=os.environ["HF_TOKEN"],
).to(torch.device("cuda"))

def transcribe(path):
    out = asr(
        path,
        return_timestamps="word",
        generate_kwargs={
            "language": "ko",
            "task": "transcribe",
            "condition_on_prev_tokens": False,   # 앞 문장에 끌려가는 환각 줄이기
            "temperature": (0.0, 0.2, 0.4, 0.6), # 결과가 이상하면 다시 시도
            "compression_ratio_threshold": 1.35, # 같은 말 반복 감지
            "logprob_threshold": -1.0,           # 자신 없는 결과 감지
            "no_speech_threshold": 0.6,          # '말 없음' 감지
        },
    )
    speakers = diar(path).exclusive_speaker_diarization
    return out["chunks"], speakers
마지막 줄의 exclusive_speaker_diarization이 위에서 말한 단일 화자 기준 결과다. 여기서 나온 화자 시간 구간과 Whisper의 단어별 타임스탬프를 대조해 가장 많이 겹치는 화자를 붙여주면 기본 정렬이 끝난다.
실무에서 제일 골치 아픈 환각 문제
Whisper를 그냥 물려 두면 녹음 중간중간에 뜬금없는 문장이 튀어나온다.
- "시청해 주셔서 감사합니다."
- "구독과 좋아요 부탁드립니다."
- "MBC 뉴스 ○○○입니다."
- 똑같은 짧은 문장이 10번, 20번 연속으로 찍히는 현상
당연히 실제 녹음에는 없는 말이다. Whisper가 유튜브나 방송 자막 데이터를 대량으로 학습하다 보니, 정적이나 미세한 배경 잡음만 있는 구간이 들어오면 영상 끝에 자주 붙던 상투적인 자막으로 빈칸을 메워버리는 버릇이 있다.
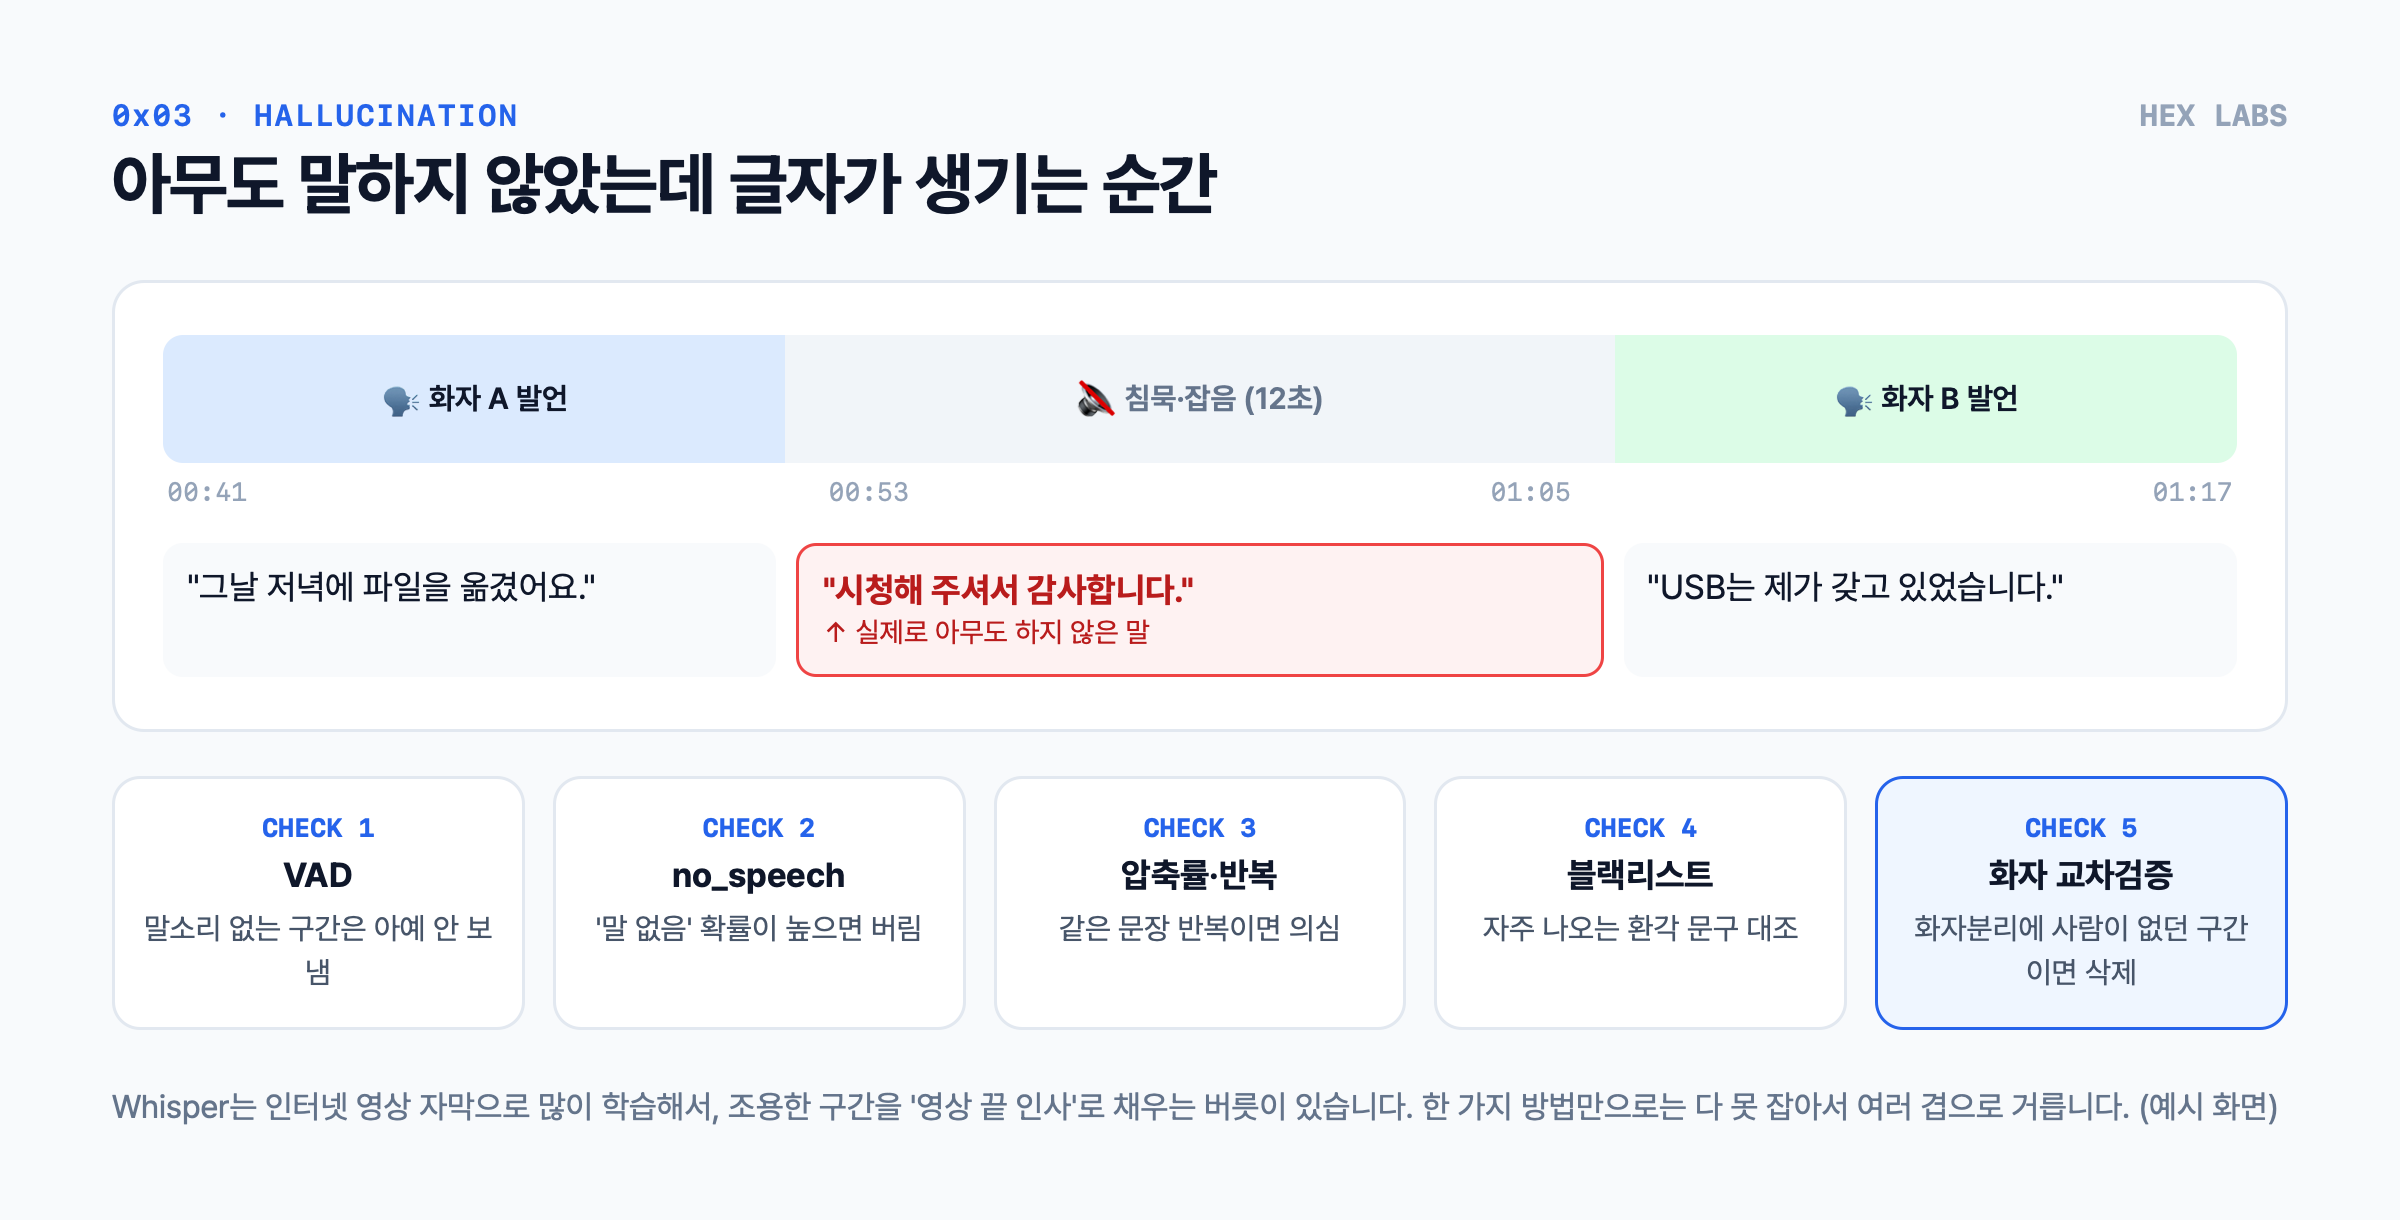
가벼운 내부 회의록이라면 그냥 지우고 넘어가면 된다. 하지만 면담이나 진술 녹음처럼 기록 자체가 근거 자료로 쓰이는 환경에서는 하지도 않은 말이 대본에 섞여 들어가는 게 가장 위험하다. 애매하면 차라리 비워 두는 편이 낫다.
환각을 걸러내는 5겹 필터
규칙 하나만으로는 다 안 잡혀서 성격이 다른 검사를 5단계로 겹쳐서 걸었다.
1. VAD로 침묵 구간을 아예 빼고 넣기
제일 효과가 확실한 방법이다. 말소리가 없는 구간을 아예 Whisper에 넘기지 않으면 환각이 생길 틈 자체가 줄어든다. 다만 기준을 너무 빡빡하게 잡으면 짧고 작게 대답한 "네…" 같은 소리까지 잘려 나가서, 발화 구간 앞뒤로 0.2~0.5초 정도 여유를 두고 자른다.
2. 무음 확률과 로그 확률 점수 확인
Whisper는 구간마다 말이 없을 확률(no_speech_prob)과 예측 결과에 대한 확신도인 평균 로그 확률(avg_logprob, 0에 가까울수록 확신이 큼)을 같이 뱉는다. 무음 확률은 높은데 확신도가 떨어지는 구간은 걸러낸다.
3. 텍스트 압축률로 무한 반복 잡기
똑같은 문장이 스무 번씩 반복되면 텍스트를 압축했을 때 용량이 확 줄어들면서 압축률(compression_ratio) 수치가 치솟는다. 임계값을 넘기면 temperature를 조금씩 높여 다시 전사를 돌리고, 그래도 반복이 남으면 이상 구간으로 표시한다.
4. 상투적 환각 문구 블랙리스트
운영하면서 실제로 자주 튀어나온 유튜브·뉴스 자막투 문구들을 목록으로 모아 뒀다. "시청해 주셔서 감사합니다", "구독과 좋아요" 같은 문구가 짧은 구간에 덩그러니 찍히면 의심 후보로 올린다. 혹시라도 실제 대화에서 저 말을 했을 가능성을 배제할 수 없으니 단독으로 바로 지우진 않고 5번 조건과 묶어서 판정한다.
5. pyannote 화자 구간과 교차검증
화자분리를 붙이면서 얻은 가장 쏠쏠한 효과다. pyannote는 Whisper와 전혀 다른 음향 모델로 사람 목소리 유무를 잡는다. Whisper는 멀쩡한 문장을 뽑아놨는데 pyannote 결과에서는 그 시간대에 아무도 말하지 않은 걸로 나온다면 환각일 확률이 아주 높다.
BLACKLIST = ["시청해 주셔서 감사", "구독과 좋아요", "MBC 뉴스", "다음 영상에서"]

def is_hallucination(seg, speakers):
    talk = overlap_seconds(seg.start, seg.end, speakers)   # 화자 구간과 겹친 시간
    ratio = talk / max(seg.end - seg.start, 0.01)
    hits = [
        seg.no_speech_prob > 0.6 and seg.avg_logprob < -1.0,
        seg.compression_ratio > 2.4,
        any(b in seg.text for b in BLACKLIST),
        ratio < 0.2,                                        # 아무도 말하지 않던 구간
    ]
    return ratio < 0.2 and sum(hits) >= 2
필터에 걸린 문장도 DB에서 완전히 날리지 않고 '제거됨' 상태와 판정 사유를 같이 남겨 둔다. 자동 필터도 가끔 작은 목소리를 오탐할 수 있어서, 검수자가 필요하면 원본 음성과 대조해 복구할 수 있어야 한다.
최종 출력 형태와 운영하면서 느낀 한계
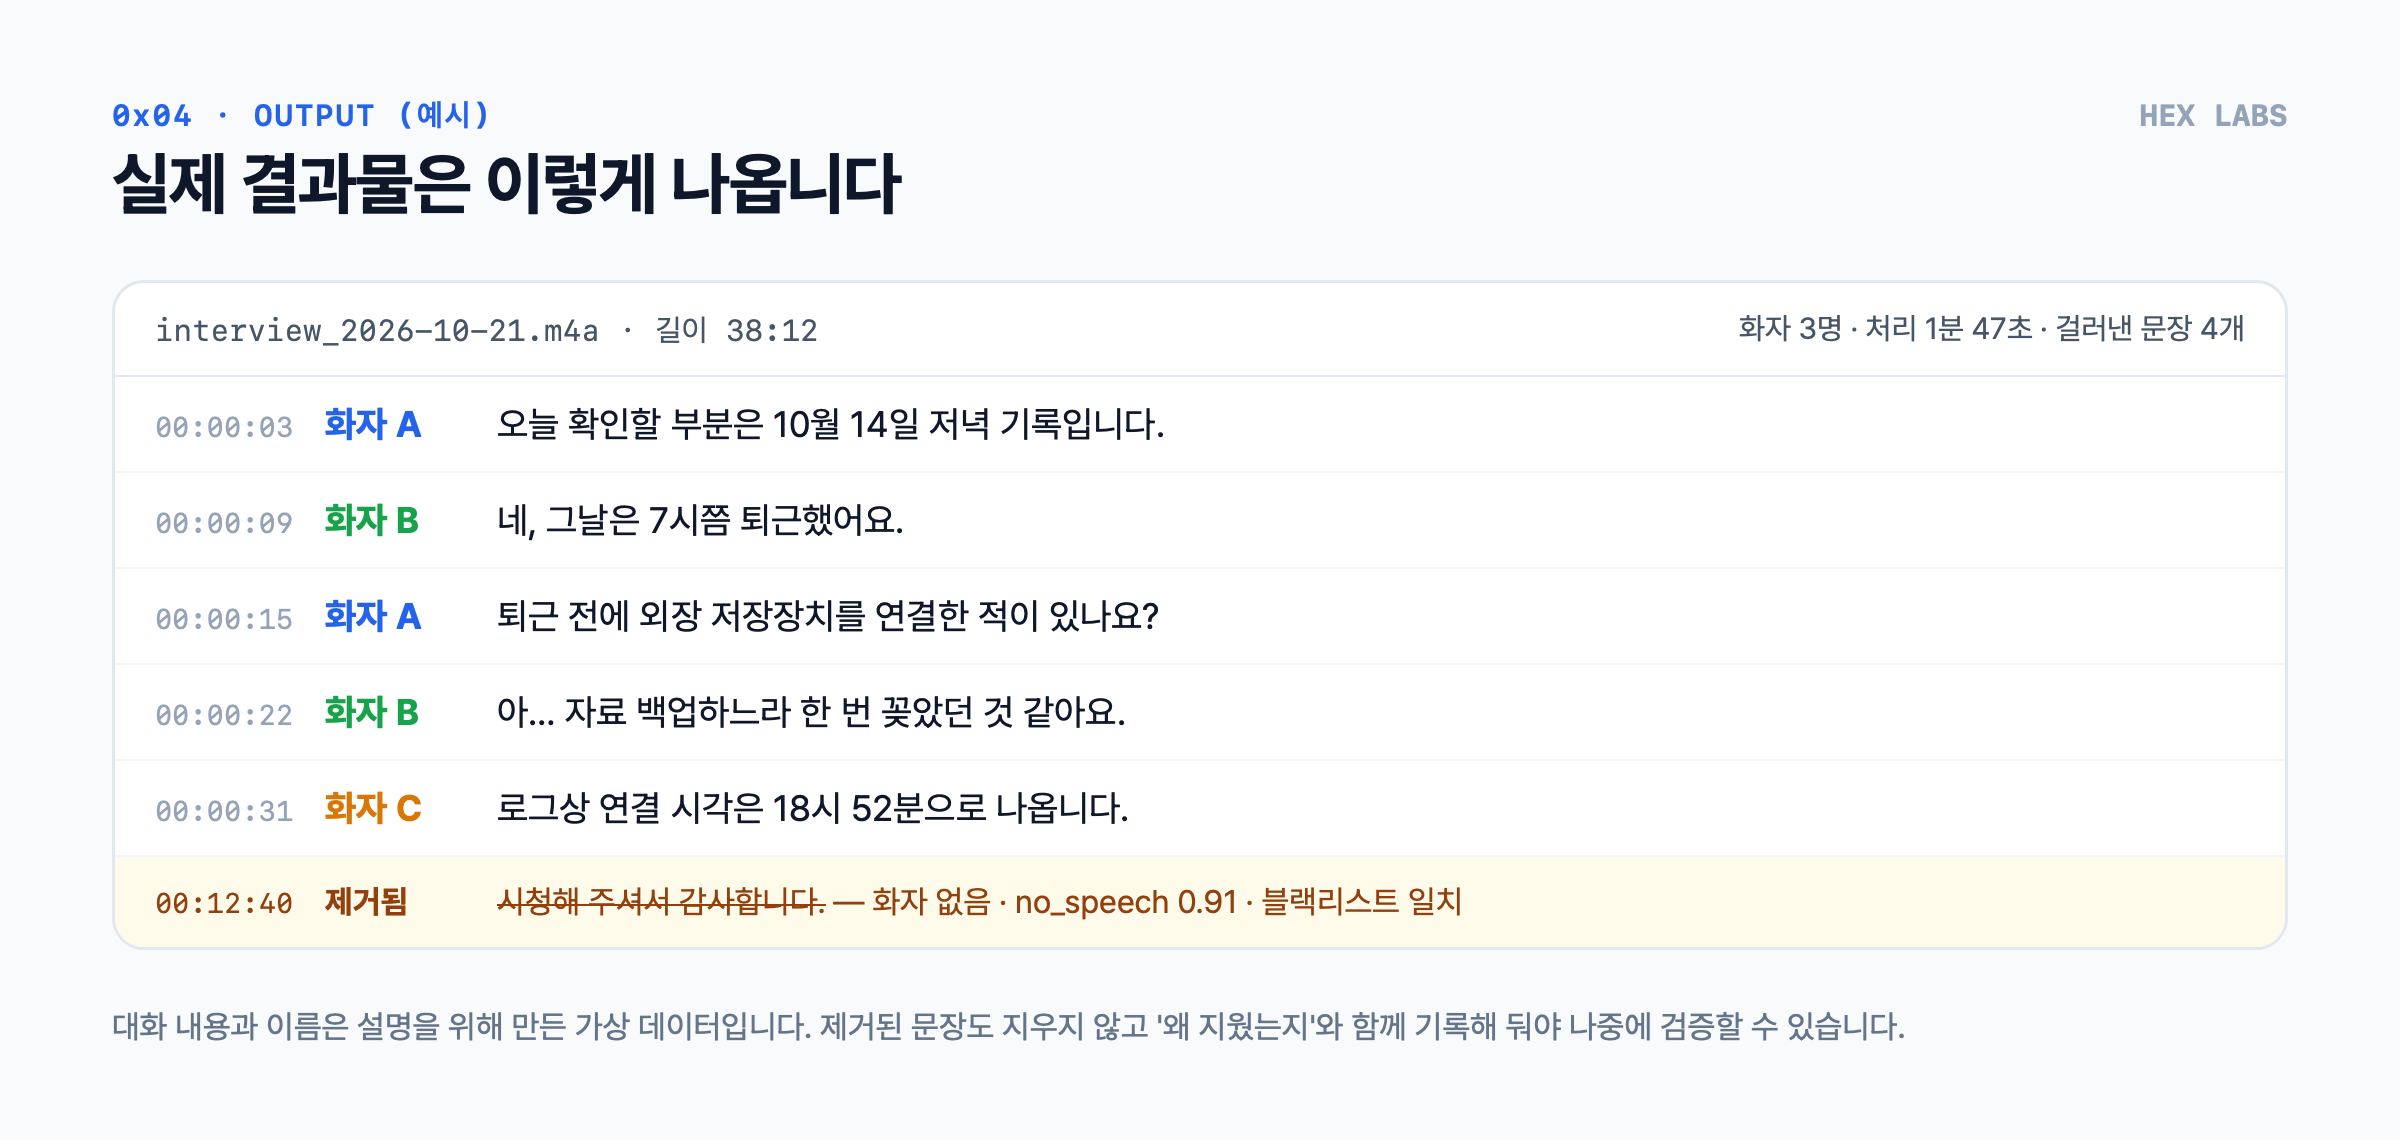
결과물은 웹 화면용 대본 외에 자막용 SRT, 후처리용 JSON, 문서 보고용 DOCX 포맷으로 같이 뽑히게 해 뒀다. 줄마다 시작 타임스탬프를 물려 놔서 애매한 문장을 누르면 바로 그 시점의 원본 오디오가 재생된다.
직접 만들어 돌려보면서 정리된 생각은 네 가지 정도다.
- 처리 속도는 이미 충분하다. turbo 모델 덕분에 GPU 연산 시간보다 사람이 눈으로 최종 검수하는 시간이 훨씬 길다.
- 체감 품질은 모델 자체보다 앞뒤 파이프라인에서 갈린다. 같은 모델을 써도 오디오 전처리, VAD 여백, 후처리 필터를 어떻게 다듬느냐에 따라 결과물 차이가 크다.
- 화자분리가 곧 훌륭한 환각 검증기다. 원래는 화자만 나누려고 붙였는데, 침묵 구간 환각을 잡아내는 데 가장 믿을 만한 교차 기준이 됐다.
- 그래도 자동 전사본은 어디까지나 초안이다. 낯선 고유명사, 금액·날짜 같은 숫자, 두 사람이 완전히 겹쳐 말한 구간은 여전히 사람이 마지막에 귀로 확인해야 한다.
참고 영상
Whisper와 pyannote를 엮어서 화자별 대본을 뽑는 전체 흐름을 다룬 시연 영상이다(영어, 조회수 약 7.6만 회).
한국어로 Whisper 기본 구조부터 가볍게 보고 싶다면 공부하는 R-report의 Whisper 소개 영상이 참고할 만하다.
참고 자료
- openai/whisper-large-v3-turbo 모델 카드 — Hugging Face
- turbo model release — OpenAI Whisper GitHub
- pyannote/speaker-diarization-community-1 — Hugging Face
- pyannote.audio 4.0.0 릴리스 노트 — GitHub
- Community-1: Open-source speaker diarization model — pyannoteAI
'AI & 자동화' 카테고리의 다른 글
| 바이브코딩, 프로그램 하나 깔면 끝이다: 코덱스·클로드·안티그래비티 초보자 시작법과 폴더 설정 (0) | 2026.10.30 |
|---|---|
| GPT·클로드 제치고 1등 찍은 제미나이 4 카본, '코딩 꼴찌'의 반전과 구글 생태계가 무서운 이유 (0) | 2026.10.30 |
| 2026 무료 OCR 모델 비교: 벤치마크 점수와 요즘 OCR이 빨라진 이유 (0) | 2026.10.30 |
| 로컬 LLM 실험을 위한 Windows WSL2 + VS Code + PyTorch 환경 구축 기록 (0) | 2024.08.05 |
| 개인 오프라인 챗봇 개발 기획 노트: 경량 모델(GPT-2) 선택부터 로컬 추론 아키텍처까지 (0) | 2024.08.05 |